원본 영상 출처 — 이 글은 스탠퍼드대학교 강의 "Stanford CS329A Self-Improving AI Agents | Part 2 | Test-Time Compute Scaling"(Stanford Online 공식 YouTube, 2026년 8월 3일 공개, 약 63분)을 한국어로 정리한 것입니다. 이 강의는 스탠퍼드 CS329A: Self-Improving AI Agents(2025년 가을학기, 담당 교수 아칸크샤 차우드허리·아잘리아 미르호세이니)의 2강 "Test-time Compute Scaling"(2025년 9월 26일)으로, 강의에서 소개하는 Large Language Monkeys·Archon·KernelBench 연구를 이끈 아잘리아 미르호세이니(Azalia Mirhoseini) 교수가 강단에 섰습니다.
한 줄 요약
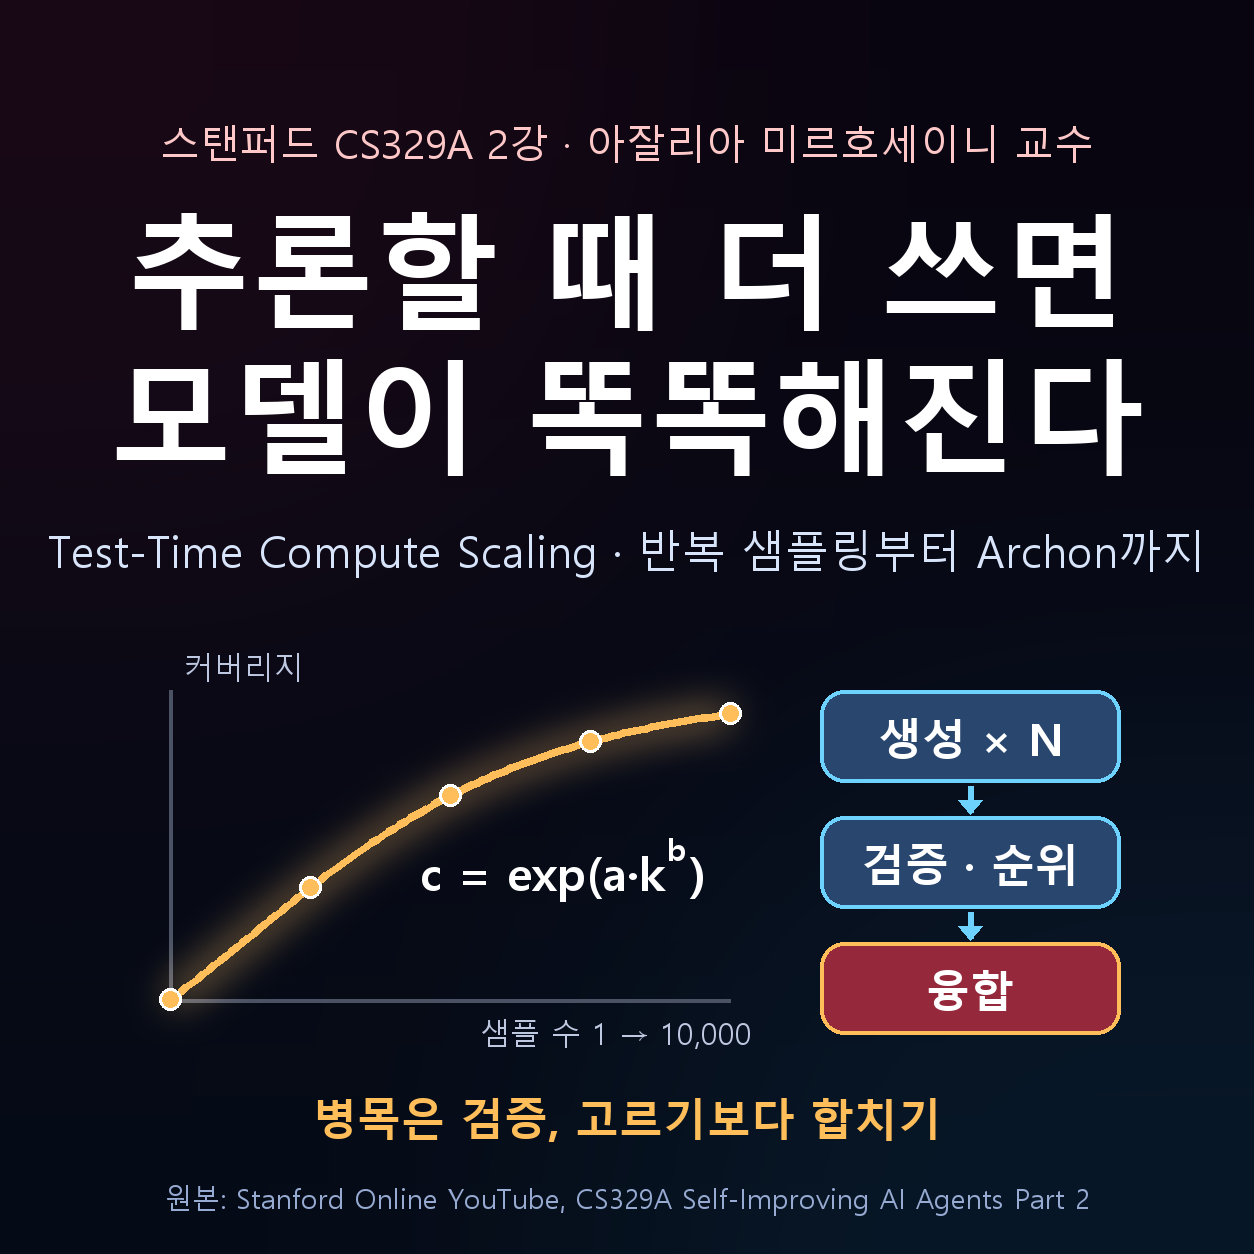
강의의 메시지는 분명합니다. "모델의 가중치를 바꾸지 않아도, 추론할 때 더 많은 계산을 쓰면 모델은 더 똑똑해진다. 단, 그 계산이 가치를 가지려면 좋은 답을 골라낼 검증 수단이 있어야 한다." 강의는 반복 샘플링(Large Language Monkeys) → 추론 스케일링 법칙 → 검증이라는 병목 → 병렬과 순차의 조합(Snell 외) → 추론 기법을 '아키텍처'로 설계하는 Archon 순서로 전개됩니다.
1. 세 번째 확장 축: 사전학습, 미세조정, 그리고 추론
LLM 개발은 세 단계로 볼 수 있습니다. 수개월 동안 막대한 GPU로 수조 토큰을 학습하는 사전학습, 그보다 훨씬 적은 데이터로 다듬는 미세조정, 그리고 모델을 실제로 쓰는 추론입니다. 강의의 첫 슬라이드 제목이 요점을 말해 줍니다. "새로운 확장의 최전선은 추론이다." 추론 단계에서 모델의 파라미터를 전혀 바꾸지 않고도 성능을 끌어올리는 방법들이 이 강의의 주제입니다.
2. Large Language Monkeys: 같은 문제를 여러 번 풀게 하라
'무한 원숭이 정리'에서 이름을 딴 이 연구의 아이디어는 단순합니다. 한 문제에 답을 한 번만 생성하지 않고 10번, 100번, 1만 번까지 반복해서 생성한 뒤, 검증기(verifier)로 맞는 답을 골라냅니다.
- 한 번 시도에서는 GPT-4o보다 약한 Llama 3 8B·70B 같은 모델도, 반복 샘플링과 정답 선별을 거치면 더 크고 비싼 독점 모델을 앞설 수 있습니다. 어려운 수학·코딩·질의응답 문제 전반에서 같은 경향이 나타났습니다.
- 강연자는 이를 "작은 모델도 이미 답을 알고 있는데, 첫 시도에서 말해 주지 않을 뿐"이라고 해석합니다. 반복 샘플링은 그 답을 끌어내는 방법이라는 것입니다.
- 에이전트형 벤치마크에서도 통합니다. 실제 소프트웨어 엔지니어처럼 코드를 고치고 패치를 만드는 SWE-bench Verified에서, 오픈소스 DeepSeek 모델에 샘플을 1천 개까지 늘리자 "적어도 하나의 샘플이 푼 문제 비율"인 커버리지가 Claude 3.5 Sonnet이나 o1-preview의 단일 시도 성적을 넘어섰습니다.
- 코딩처럼 단위 테스트로 정답을 가려낼 수 있는 영역이라면, 이 과정 전체가 사람 개입 없이 자동으로 돌아가 더 유능한 시스템을 만들어 냅니다.
3. 추론에도 스케일링 법칙이 있다
사전학습에서 데이터·계산량·파라미터를 늘리면 손실이 예측 가능하게 줄어드는 스케일링 법칙이 있듯, 추론 시점에도 비슷한 법칙이 관찰됩니다. 커버리지(c)와 샘플 수(k)의 관계는 c = exp(a·kb) 형태의 '지수화된 멱법칙'으로 잘 맞아떨어지며(a, b는 모델별로 맞추는 계수), 7천만 파라미터 모델부터 700억 파라미터 모델까지, Llama 3·Gemma·Pythia 등 여러 계열에서 성립했습니다. 즉 원하는 커버리지에 도달하려면 샘플이 몇 개 필요하고 자원을 얼마나 배정해야 하는지를 미리 예측할 수 있다는 뜻입니다.
흥미로운 질문은 "왜 멱법칙인가"입니다. 문제 하나만 보면, 한 번에 맞힐 확률이 p일 때 k번 중 한 번이라도 맞힐 확률은 1-(1-p)k로 지수적으로 올라갑니다. 그런데 문제 집합 전체로 보면 멱법칙이 나타납니다. 후속 연구(Schaeffer 외, "How Do Large Language Monkeys Get Their Power (Laws)?", ICML 2025)가 밝힌 답은 '아주 어려운 문제의 긴 꼬리'입니다. 대부분의 문제는 첫 시도에 풀리지만, 첫 시도 정답 확률이 극히 낮은 어려운 문제들이 길게 이어져 있고, 이 분포가 멱법칙의 필요충분조건이라는 것입니다. 실제 데이터에서도 이 조건이 확인되었습니다.
산업적 의미도 큽니다. 예전에는 사전학습에 수억~수십억 달러를 쓰고, 추론은 사용자와 모델이 한 번 주고받는 거의 공짜에 가까운 단계였습니다. 이제는 추론에 훨씬 많은 계산을 써서 능력을 끌어올리는 새로운 패러다임이 열렸고, 이 계산은 오프라인에서도 가능합니다. 에이전트를 풀어 놓고 토큰을 계속 생성하며 답의 품질을 개선하게 할 수 있다는 것입니다.
4. 병목은 '검증'이다
샘플을 아무리 많이 뽑아도, 그중 무엇이 정답인지 모르면 소용이 없습니다. 강의는 자동 검증이 가능한 영역과 그렇지 않은 영역을 나눕니다.
- 검증이 쉬운 영역: 수학의 형식 증명(증명 검사 도구로 각 단계를 확인), 코딩의 단위 테스트(프로그램 전체를 짜는 것보다 테스트를 쓰는 편이 대개 쉬움), 언어 간 변환. 강연자가 특히 기대하는 방향은 '컴파일러로서의 AI'입니다. PyTorch 코드를 저수준 GPU 코드인 CUDA로 LLM이 변환하게 하면, 같은 입력에 대한 두 코드의 출력을 비교하는 것만으로 정답 여부를 가릴 수 있어 사실상 완벽한 검증기가 생깁니다. 연구실의 CUDA 생성 벤치마크 KernelBench에서도 샘플 수를 늘릴수록 커버리지가 꾸준히 올랐습니다.
- 검증기가 없는 영역: 여기서는 '생성-검증 격차(generation-verification gap)'가 드러납니다. 가장 많이 나온 답을 고르는 다수결은 샘플 10~50개 무렵에서 정체하고, 보상 모델로 점수를 매겨 고르는 방식도 완벽한 검증기를 가정한 커버리지와 큰 차이를 보입니다. 문제가 어려울수록(GSM8K보다 MATH에서) 격차는 더 벌어집니다.
다수결이 실패하는 이유도 명확합니다. 가장 어려운 문제의 정답은 수천~수만 개 샘플 가운데 한두 번, 많아야 서너 번만 나타납니다. 드물게 나오는 정답은 다수결로 잡을 수 없습니다. 강연자는 문제당 1만 개 샘플 데이터셋을 Hugging Face에 공개해 두었다며, 이 격차를 줄이는 방법을 수강생 연구 프로젝트 주제로 권합니다. 동시에 단위 테스트가 코드를 충분히 덮지 못하면 틀린 답이 통과하는 실패도 생기므로 "검증기의 품질이 중요하다"는 점을 다시 강조합니다. 여러 약한 검증기를 약지도 방식으로 묶는 연구(Weaver)는 다음 강의 주제로 예고됩니다.
5. 병렬로 넓게, 순차로 깊게: 계산을 어떻게 배분할까
두 번째로 다루는 논문은 Snell 외의 "Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters"입니다. 추론 계산을 쓰는 방식은 크게 두 가지입니다.
- 병렬 샘플링: 같은 질문에 여러 답을 동시에 생성하고 고르기.
- 순차 수정: 한 답을 내놓고 여러 각도에서 계속 고쳐 나가다가 확신이 서면 최종 답을 내기. 요즘의 추론 모델은 이런 행동을 학습을 통해 스스로 합니다.
답을 고르는 방법도 두 가지 보상 모델로 나뉩니다. 최종 답에만 점수를 주는 결과 보상 모델(ORM)과, 풀이의 각 단계마다 점수를 주는 과정 보상 모델(PRM)입니다. PRM을 쓰면 각 단계에서 점수가 높은 가지만 남기고 나머지를 잘라 내는 빔 서치로 탐색을 이끌 수 있고, 병렬 샘플 각각에 순차 수정을 붙인 뒤 PRM이나 ORM으로 최종 답을 고르는 조합이 대체로 더 좋은 결과를 냅니다. 이미 공개된 PRM을 가져다 쓰거나 자기 데이터로 직접 학습시킬 수도 있습니다.
이 연구는 문제를 첫 시도 정답률 기준으로 다섯 단계 난이도로 나눠 분석했고, 강의에서 짚은 관찰은 이렇습니다.
- 쉬운 문제에서는 순차 수정 비중을 높일수록 정확도가 높았습니다. 어려운 문제에서는 병렬과 순차의 최적 비율이 구간마다 달라 단정하기 어렵습니다.
- 쉽거나 중간 난이도의 문제에서는 추론 계산을 늘리는 편이 사전학습을 키우는 것보다 유리했습니다. 그러나 가장 어려운 문제에서는 여전히 더 크게 사전학습한 모델이 낫습니다. 강연자의 연구실에서도 같은 경향을 봐 왔다고 합니다. 작은 오픈소스 모델이 추론 계산을 더할수록 쓸모가 커지지만, 아주 어려운 문제에서는 무한한 추론 예산을 가정해도 프런티어 모델이 앞선다는 것입니다.
- 사전학습은 한 번이지만 추론 비용은 매번 든다는 지적에 대해, 강연자는 이렇게 답합니다. 누구나 대형 모델을 사전학습할 수는 없으니 많은 문제에서 추론 확장이 현실적인 선택이지만, 가장 어려운 문제를 위해서는 사전학습도 계속 필요하다는 것입니다.
6. Archon: 추론 기법을 '아키텍처'로 설계하기
강의 후반은 강연자 연구실의 Archon(Saad-Falcon 외, 수업 조교가 공저자) 소개입니다. 질문은 이것입니다. 여러 추론 기법과 여러 모델을 어떻게 섞고 쌓아야, 정해진 예산 안에서 최고의 정확도를 얻을까? Archon은 이를 신경망 구조를 설계하듯 '추론 아키텍처 설계' 문제로 바꿉니다. 목표 벤치마크, 추론 호출 예산, 쓸 수 있는 LLM 목록, 추론 기법 목록을 넣으면, 최적화기(ITAS)가 이들을 조합한 아키텍처를 찾아 줍니다.
조합에 쓰이는 연산은 모두 별도 학습 없이 프롬프트만으로 구현됩니다.
- 생성(generator): 후보 답을 여러 개 생성.
- 융합(fuser): 질문과 후보 답 k개를 함께 보여 주고 하나의 최종 답으로 종합하게 함.
- 비평(critic): 각 답의 강점과 약점을 서술.
- 순위(ranker): 후보 답을 품질순으로 정렬.
- 검증(verifier): 답이 맞는지 판단하고 그 근거를 제시.
- 단위 테스트 생성·평가: 문제에 맞는 테스트를 만들고, 테스트를 실행하는 대신 모델이 답을 테스트에 비추어 평가.
가장 인상적인 결과는 융합입니다. 샘플 수를 1개에서 10개로 늘리는 실험에서, 무작위 선택 < 모델에게 순위를 매기게 해 1등 선택 < 정답을 아는 '오라클' 선택 순으로 성적이 좋아졌는데, 후보들을 융합한 답은 오라클 선택보다도 좋았고, 상위 5개만 골라 융합한 방식이 가장 좋았습니다. 서로 다른 모델 여러 개의 답을 섞은 앙상블 실험에서도 같은 순서가 유지되었습니다. 좋은 답을 '고르는' 것을 넘어 여러 답을 보고 '더 나은 답을 새로 쓰는' 것이 가능하다는 뜻입니다.
또 하나의 관찰은 층을 깊게 쌓을수록 좋아진다는 점입니다. 여러 모델의 생성 → 비평 → 순위 → 융합을 여러 층으로 반복한 아키텍처가, 최고 모델을 한 번 쓰거나 여덟 번 써서 한 번 융합하는 방식보다 여러 과제에서 뚜렷하게 앞섰습니다. 딥러닝에서 층을 추가하면 모델이 좋아지는 것과 닮았다는 설명입니다.
탐색 비용이 크기 때문에 탐색 공간은 경험적으로 좁혔습니다. 층마다 기법은 하나, 첫 층은 항상 생성, 비평은 순위·융합보다 앞에, 단위 테스트 생성 뒤에는 반드시 평가를 두는 식입니다. 최적화에는 탐욕 탐색이나 무작위 선택보다 적은 시도로 수렴하는 베이지안 최적화를 썼습니다. 결과적으로 오픈소스 모델만으로도 당시 최상위 독점 모델을 크게 앞섰고, 슬라이드 기준으로 Archon은 지시 수행·추론·수학·코딩 과제에서 GPT-4o와 Claude 3.5 Sonnet보다 pass@1 기준 평균 14.1% 높았습니다. 특정 과제에 맞춰 최적화한 버전뿐 아니라 여러 과제에 두루 쓰도록 최적화한 범용 버전도 좋은 성적을 냈습니다.
7. 토론에서 나온 연구 방향
강의 중간중간 수강생들과 나눈 토론에서는 이런 아이디어가 나왔습니다.
- 샘플을 많이 뽑는 것 자체보다 검증기의 품질이 결과를 좌우한다는 핵심 정리.
- 곧바로 답을 뽑기 전에 모델이 먼저 문제 영역을 탐색하며 통찰을 모으게 한 뒤 병렬 샘플링으로 넘어가는 방식. 강연자는 자기 학습·탐색·도구 사용처럼 반복 샘플링을 넘어서는 방법들을 이후 강의에서 다룬다고 답합니다.
- 정답을 확인하기는 어려워도 오답을 걸러내기는 쉬운 영역에서, 시뮬레이션이나 다른 도구·모델로 틀린 답을 제거하는 방식.
- 검증기를 여러 개 만들어 다수결을 내는 방식. 계산 비용은 크지만 유망한 방향으로, 앞서 예고한 Weaver 연구로 이어집니다.
필자의 정리: 2026년에 이 강의가 주는 교훈
- 여러 번 시도하고 고르는 것은 이제 기본기다. 코딩 에이전트가 여러 해법을 만들고 테스트로 걸러 내는 방식은 이 강의의 반복 샘플링과 검증 원리를 그대로 옮긴 것입니다.
- 자동화하고 싶다면 먼저 '검증 가능하게' 만들어라. 단위 테스트, 입출력 비교, 형식 검사처럼 기계가 정답을 판정할 수 있는 장치가 있으면 추론 계산이 곧 성능이 됩니다. 없으면 생성-검증 격차에 막힙니다.
- 고르는 것보다 합치는 것이 강할 수 있다. 후보 여러 개를 보여 주고 종합하게 하는 융합은 프롬프트 몇 줄로 시도할 수 있는 가장 싼 개선책입니다.
- 예산을 정하고 배분을 설계하라. 쉬운 문제에는 추론 계산이 사전학습보다 효율적이지만, 가장 어려운 문제에는 더 강한 기반 모델이 여전히 필요합니다. 작업 난이도에 따라 병렬·순차·모델 선택을 달리하는 것이 비용 대비 효과를 가릅니다.
출처
- 원본 강의 영상(스탠퍼드 공식): Stanford CS329A Self-Improving AI Agents | Part 2 | Test-Time Compute Scaling (Stanford Online YouTube, 2026년 8월 3일 공개)
- 강의 페이지: Stanford CS329A: Self-Improving AI Agents (2025년 가을학기, Aakanksha Chowdhery·Azalia Mirhoseini, 2강 "Test-time Compute Scaling", 2025년 9월 26일)
- 영상을 접한 경로(재업로드): @noisyb0y1의 X 게시물 (2026년 9월 25일)
- Brown 외, Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
- Schaeffer 외, How Do Large Language Monkeys Get Their Power (Laws)?
- Snell 외, Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters
- Saad-Falcon 외, Archon: An Architecture Search Framework for Inference-Time Techniques
- Ouyang 외, KernelBench: Can LLMs Write Efficient GPU Kernels?
- Saad-Falcon 외, Shrinking the Generation-Verification Gap with Weak Verifiers (Weaver)
'푸닥거리' 카테고리의 다른 글
| 앤드류 응 교수의 LLM 앱 개발 강의 정리: 프롬프트를 넘어 추론 엔진·과업 분석·평가·에이전트까지 (NeurIPS 2023) (0) | 2026.09.24 |
|---|---|
| AI 에이전트, 무엇을 설계할까? 네 개의 영상에서 얻은 실무 인사이트 (0) | 2026.09.23 |
| 인프라 설계 핵심 9가지: L4·L7부터 세션·JWT까지, 선택 기준으로 이해하기 (0) | 2026.09.13 |
| 장한평역·한국산업인력공단 2112번 버스: 갈 때 빨간 표지, 올 때 파란 표지 (0) | 2026.09.07 |
| 벡터 RAG 다음은 무엇인가: Graph RAG·온톨로지 월드모델로 가는 3단계 (0) | 2026.08.31 |


댓글